
最近在几场面试和一些技术讨论群里,我注意到一个现象:不少人在解决 CV 问题时,思路仍然停留在「死磕检测、分割这类传统算法」上,把小模型在单卡、单芯片上的并发路数一提再提,力求榨干芯片的最后一点价值。不可否认,在 2026 年的今天,CV 小模型依然在发光发热——但它发挥价值的方式,和前几年相比已经完全不一样了。
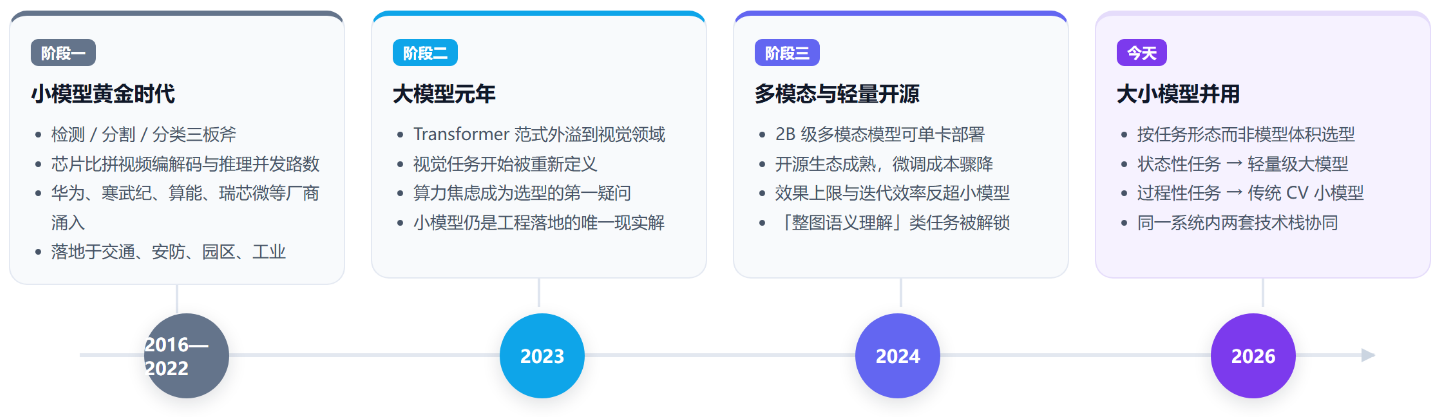
大模型之前:小模型的黄金十年
在大模型出现之前,CV 小模型是解决视觉任务的主流技术栈,广泛应用于交通、安防、园区、工业等领域。2016 到 2022 年间,国内涌现出一大批图像算力厂商——华为、寒武纪、算能、瑞芯微,以及无数叫不上名字的小厂。这些硬件一方面提供视频编解码加速,一方面提供 CV 模型推理加速(当时面向 NLP 的还不多)。这一时期的 CV 模型主要承担目标检测、图像分割、图像分类等任务,业务系统再基于模型输出完成后续逻辑,比如状态判断、行为分析、图像检索等。
2023 年大模型登场,尤其是 2024 年以来,多模态与轻量级大模型的开源生态日趋成熟,处理 CV 任务的方式开始发生实质变化。传统小模型虽然算力消耗更低,但在效果上限、以及算法上线之后的扩展与迭代成本上,已经不再有优势。
结合我自己的项目经验,现阶段解决 CV 问题更合理的做法是:大小模型并用;退一步说,至少也要在合适的场景里,认真把轻量级大模型纳入选型范围。而判断「合不合适」的关键,在于任务本身是状态性的,还是过程性的。
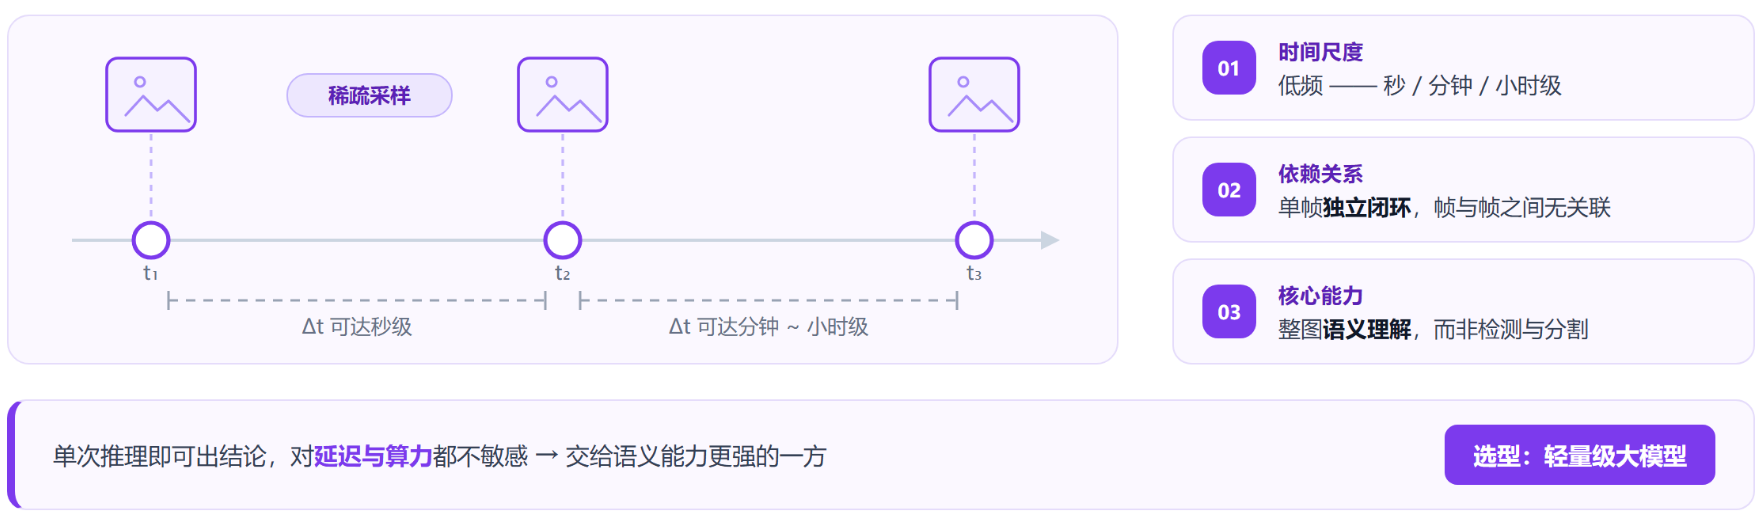
状态性分析任务:低频、独立、看语义
指那些对推理频次要求不高的场合——几秒一次,甚至几分钟、几小时才推理一次。这类任务最大的特点是:每次推理相互独立,如果输入是视频,前后帧的推理结果不需要关联,因此推理间隔可以拉得很大。比如气象监测、图片鉴黄、表情识别,靠一帧画面就能分析出结果。
这类任务非常适合轻量级大模型:推理频次低,意味着算力压力小。更重要的是,有一批传统小模型很难解决的状态性任务——「判断货架上纸箱是否侧翻,商品A是否在商品B的右侧」「施工现场施工设备摆放是否合规」,这类问题需要对整张图片做语义理解,靠检测、分割、分类的组合拳很难拼出来,建议直接考虑大模型方案。
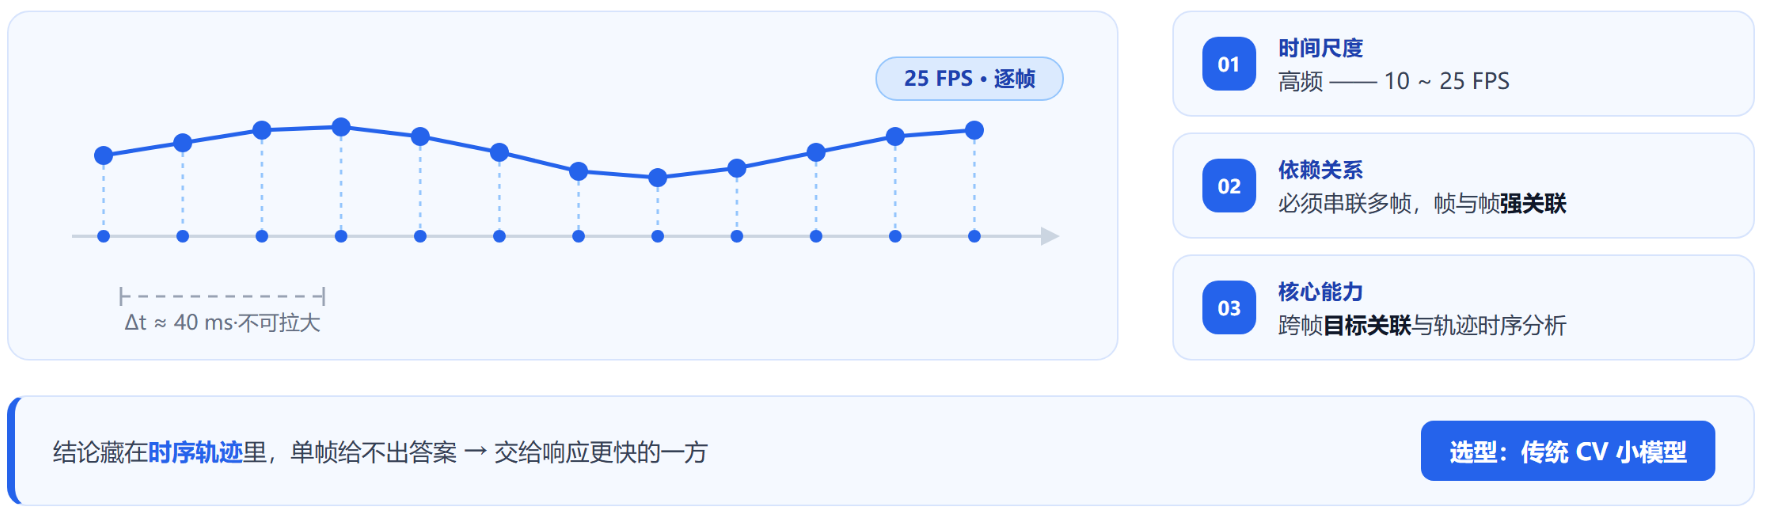
过程性分析任务:高频、连续、看轨迹
与之相对,过程性分析任务对推理频次要求很高——每秒推理 10 次(10 FPS)、甚至 25 次(25 FPS)。这类任务的特点是:单次推理无法得出结论,必须依赖连续多次推理;如果输入是视频,前后帧结果需要关联,推理间隔不能拉大。比如目标停止、车辆逆行,必须通过连续的帧序列判断(先做目标关联,再分析轨迹),单帧画面给不出答案。
这类任务仍然是传统小模型的主场——它响应快、单帧成本低,能够满足高帧率下的实时性要求。
注意,这里的过程性分析任务不包含支持视频片段作为输入的大模型应用场景,这是另外一个话题。
总结
有人可能会质疑:大模型对算力要求高,工程上根本落不了地。其实以 2B 左右的轻量级大模型为例,它对算力的实际需求、以及能带来的效果价值,大概率超出大部分人的意料,可以参考之前的两篇文章:
http://www.videopipe.cool/index.php/2026/07/16/1-18/
http://www.videopipe.cool/index.php/2025/08/22/1-15/
一个系统里往往同时存在多种任务,解决一个任务也可能需要多种算法配合。按上面的思路选择合适的技术栈——技术选型从来不是非黑即白,大小模型并用,反而是最常见的形态。
